映月湖创新沙龙006|AI视觉的下一站
发布时间:
近百位研究者、创业者与产业实践者相聚人才港,与Luc Van Gool等11位嘉宾共同探讨3D视觉、世界模型、AI for Science和企业Agent,让前沿研究连接真实应用。
在人才港相遇,连接视觉智能的下一站
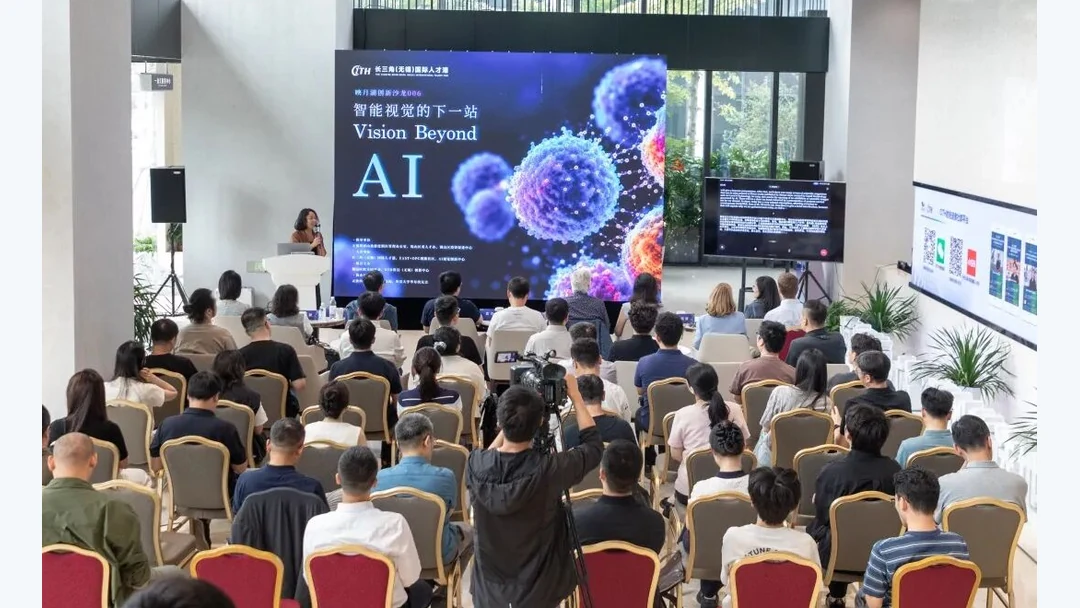
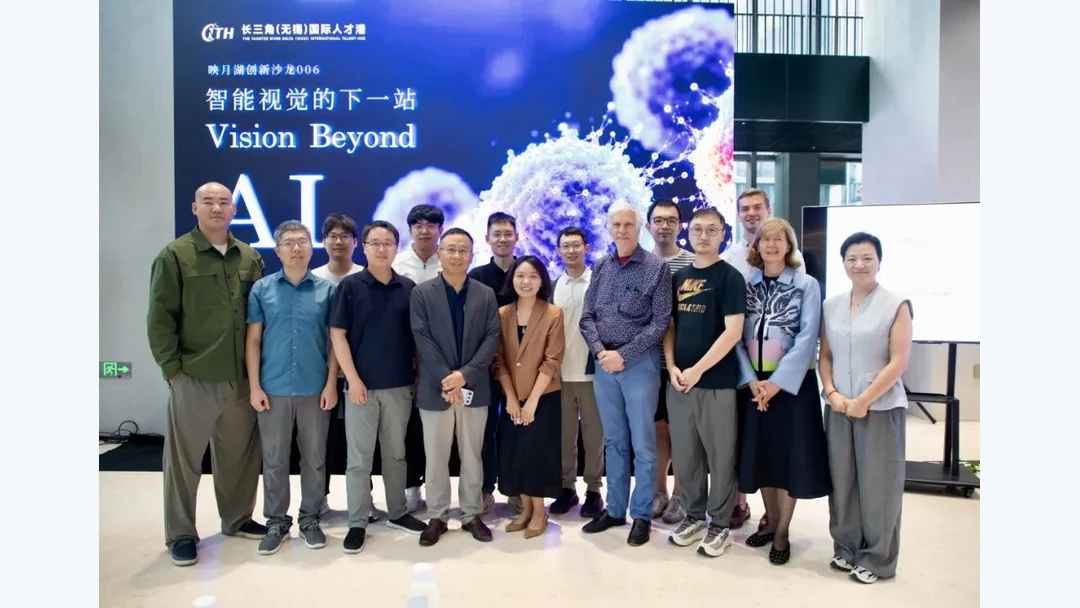
国庆节前,近百位来自高校、科研机构、科技企业和创业一线的嘉宾齐聚长三角(无锡)国际人才港,共同参与映月湖创新沙龙第六期《Vision Beyond AI:视觉智能的下一站》。
除了人才港的创业者外,现场有来自北京、上海、杭州、深圳等地的AI创业者和研究者,也有不少来自欧洲、长期与Luc Van Gool教授保持学术和创业联系的学生、同行与朋友。大家围绕3D视觉、世界模型、视觉模型轻量化、AI for Science、3D生成、智能体育以及企业Agent等方向展开了深入交流。
活动特别感谢无锡翠屏山旅游度假区管理办公室、锡山区委人才办、锡山区投资促进中心的指导,感谢锡山区欧美同学会、GTB鲁汶(无锡)创新中心的联合主办,还有灵汲科技、鲁汶大学校友会、映月湖科技园的大力支持。
Luc Van Gool|从2D“教师”理解3D世界
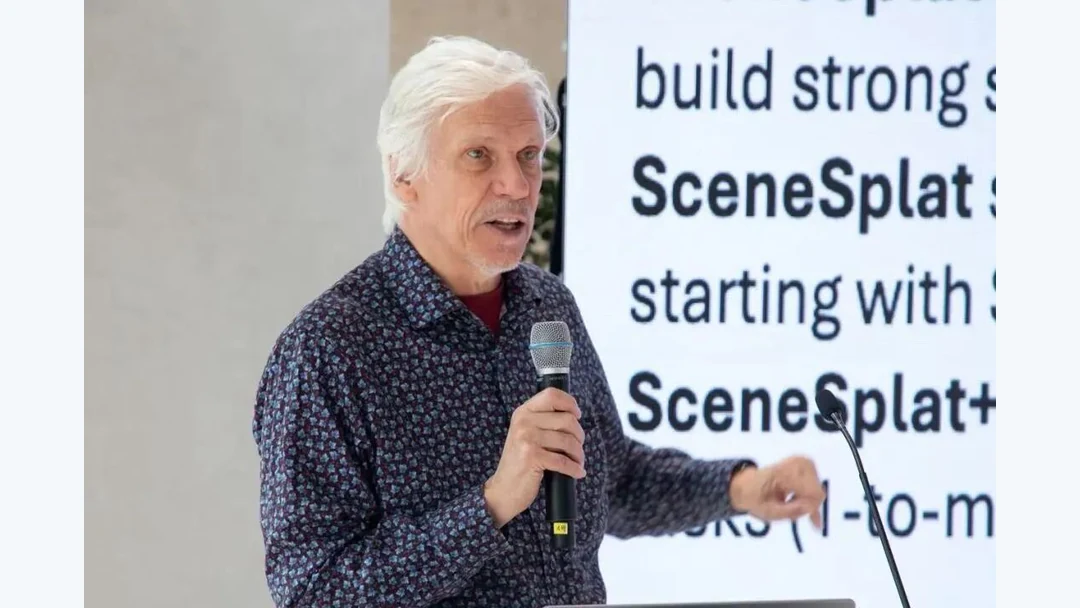
活动开场,国际计算机视觉领域科学家、原苏黎世联邦理工学院和鲁汶大学教授、现INSAIT教授兼ELLIS Sofia负责人Luc Van Gool带来了《CHORUS:从2D“教师”理解3D世界》的分享。
这是Luc教授第三次来到长三角(无锡)国际人才港,他也是人才港AI视觉创新中心的发起人之一。人才港成立三年,他每年都会来到无锡驻留,与这里的AI创业者、研究人员以及自己的学生交流。这一次,他带来了团队在3D视觉理解方向上的最新研究。
近年来,3D Gaussian Splatting(3DGS)成为三维视觉领域的重要技术路径。它能够高效地重建真实场景,并获得非常出色的视觉表现。但对于机器而言,一个“看起来很真实”的三维场景,并不意味着它已经真正理解了其中的物体、空间关系和语义。
团队提出了一套多教师预训练框架,将来自不同2D基础模型的知识迁移到原生的3D Gaussian表示中。语言对齐、通用视觉以及目标感知等不同类型的2D模型,可以被视为不同的“教师”,通过共享的骨干网络以及针对不同教师的投影器,将各自拥有的视觉和语义知识共同用于训练3D场景编码器。
这种方法的关键,在于最终形成的并不是一个简单依赖二维图像的系统。经过训练之后,CHORUS可以直接从3D Gaussian的参数中提取结构化语义特征,使三维场景本身具备更丰富的理解能力。
从ShapeSplat、SceneSplat,到SceneSplat-49K,再到CHORUS,Luc教授团队持续推进着从物体级3D表示、室内场景理解到更广泛3D场景语义编码的研究。CHORUS进一步将这种能力扩展到3D Gaussian和Point Cloud等不同输入形式,并支持语义分割、实例分割、开放词汇视觉问答等任务。
这意味着,未来人们面对一个三维场景时,可以提出的不再只是“这里是什么”,还可以进一步询问:“我的红色包在哪里?”“家具应该按照怎样的顺序移动?”在城市数字孪生中,也可以进一步询问“哪些交通标志存在视觉遮挡”等具体问题。
当3D空间能够被语言询问、被语义检索并参与任务决策时,它就开始从一个可以观看的数字模型,转变为可以被理解和交互的空间信息载体。
贾旭|从可控生成到物理可信的世界模型
如果说3D视觉解决的是“AI如何理解空间”,那么大连理工大学教授、博士生导师贾旭讨论的,则是AI如何进一步理解真实世界中的变化与规律。
作为Luc Van Gool教授的学生,贾旭教授长期研究生成模型、视频理解和世界模型,曾任职于华为诺亚方舟实验室、商汤科技和Google Research。
随着视频生成模型快速发展,AI已经能够生成越来越逼真的人物、场景和运动。但一个视频看起来真实,并不意味着它真的符合物理世界。对于真正的世界模型而言,视觉上的逼真只是基础,模型还需要理解动作、因果关系以及不同状态之间的变化。
贾旭教授将世界模型理解为一种条件概率模型。模型需要根据历史观察、任务环境以及动作序列,对未来可能发生的状态进行预测。
一个真正具有世界建模能力的系统,需要同时满足三个条件:可控性、物理合理性以及交互一致性。
围绕这一方向,他介绍了团队在VFX Master、Camera Master、多镜头视频生成以及物理先验等方面的研究。例如,通过参考视频控制视觉特效迁移,通过三维深度和轨迹约束控制摄像机运动;在视频生成过程中引入视觉语言模型提供的物理知识,使铁块下沉、液体流动等过程更加符合现实规律。
在更复杂的任务中,模型还需要理解连续发生的动作。例如揉面并不是一个单一动作,而是由多个连续步骤构成。团队进一步探索Transition VLM,让模型能够理解和生成这样的多步骤过程。
在具身智能方向,MemWorld则尝试让机器人拥有更持续的4D时空记忆,使模型能够处理腕部摄像头遮挡、长时间任务中的记忆检索,以及长期动作与环境之间的一致性。
从视频生成到世界模型,AI正在逐渐从“生成一段看起来合理的视频”,走向预测一个动作发生之后,世界会发生什么。
孙国磊|让多模态视觉模型更轻、更可用
同样作为Luc Van Gool教授的学生,南开大学教授、博士生导师孙国磊长期从事视觉模型、视觉语言模型与长视频理解等方向的研究。他此次分享的重点,是视觉模型的轻量化,以及如何在尽可能保持模型能力的同时,降低视觉信息处理带来的计算和存储成本。
随着视觉模型不断扩大,图像和视频中的大量视觉信息会转化为视觉Token,并成为模型推理过程中重要的计算负担。孙国磊团队围绕视觉Token压缩、模型量化等方向展开研究,希望让视觉模型在保持较高性能的同时,以更低的计算成本运行。
在相关研究中,通过视觉Token压缩,可以将部分7B模型的视觉输入压缩到16个Token,在保持约92%性能的情况下获得约2.4倍的速度提升。进一步的ASA方法可以将视觉Token压缩到原来的约10%,在部分任务中保持接近原有性能,同时将计算量降低到原来的约14%,推理速度也得到明显提升。
团队还探索了W4A4等低比特量化方法,通过降低权重和激活值的精度,进一步减少模型的显存和推理成本。在相关视觉语言模型上,这类方法使原本需要较高显存配置的模型有机会进入更加有限的计算环境。
这类研究解决的并不只是“模型能不能运行得更快”,而是一个更加现实的问题:当视觉模型越来越强,如何让它摆脱对高算力硬件的依赖,真正进入普通工作站、边缘设备以及更多真实应用场景。
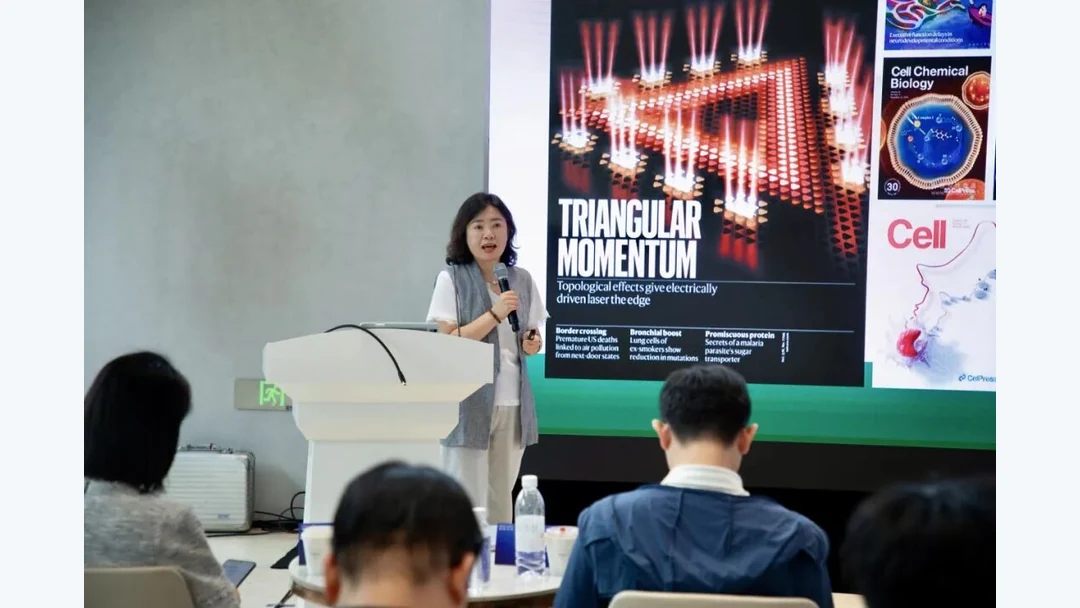
韩颖|科学图像不仅要好看,更要准确
科学可视化专家、松迪科技创始人韩颖从一个更加具体的角度讨论了AI与科学图像之间的关系。
从2007年创办公司至今,韩颖已经在科学可视化领域工作近20年,长期服务于高校、科研机构以及国际科学出版体系,并参与过Nature、Science、Cell等期刊相关视觉项目。
活动现场,韩颖展示了几组科学图像,让观众判断哪些来自人工制作,哪些由生成式AI完成。随着生成式AI能力提升,科学图像的制作效率正在发生变化,但这并不意味着AI已经真正理解了科学。
AI可以生成非常复杂、视觉效果丰富的图像,但其中也可能出现信息冗余、文字错误以及科学逻辑不准确的问题。对于科学出版而言,图像不仅需要好看,更需要准确表达实验机制、数据关系和科学结论,因此目前仍有部分出版体系对完全由AI生成的科学图像保持谨慎。
在韩颖看来,现阶段AI更适合成为科学可视化工作中的重要辅助工具,例如寻找视觉灵感、制作背景和辅助素材等。
松迪也正在与灵汲科技等团队合作,将传统科学绘图工具逐渐转化为在线可编辑工具,并尝试训练面向科学图像的模型和建设“科图网”等平台。
从“AI能不能画图”,到“AI能不能理解科学”,科学可视化正在成为观察AI能力边界的一面镜子。
金桐辉|让AI从辅助科研走向执行科研
灵汲科技创始人金桐辉关注的则是AI4S如何进一步加速科学研究、技术开发和产品落地本身。
金桐辉拥有ETH Zurich博士背景,长期从事AI for Science与AI视觉生成研究,相关成果发表于Nature Nanotechnology、Advanced Materials等期刊。
金桐辉在活动中介绍了灵汲正在推进的AI for Science Agent生态,以及面向高校科研人员、企业研发人员的桌面级智能体leapsea。leapsea通过自研AI4S Harness和后训练系统,试图让人人都可以轻松做AI4S。
用户可以通过自然语言提出需求,通过闭环Agent进一步完成科学可视化、研究复现、产品开发、工程落地以及Computer Use等功能,实现全科技场景、全学科覆盖的智能体终端。
例如,用户可以直接提出对AlphaFold核心原理或溶菌酶相关研究机制的理解需求,由Agent协助完成分析和可视化。在工程场景中,也可以进一步生成GDS等专业文件。
团队还测试了BioBench100、Math Science Bench、ASvA Bench等评测体系,对leapsea在不同科学任务中的表现进行测试,各项测评数据均实现了国内顶尖水平。
更值得关注的是Skill Market的思路。研究人员可以把自己的专业方法一键封装成可复用的Agent Skill,通过技能市场分享和变现。
这意味着AI for Science正在从一个“回答科研问题的工具”,逐渐向一个能够实现研究团队专业技能流转、执行研发流程,并进一步连接真实实验设备的系统发展。
马里千|AI视频创作需要完整的工作流
Creati AI联合创始人兼CTO马里千同样是Luc Van Gool教授的学生,拥有鲁汶大学博士背景,曾在Toyota Europe、Adobe等机构从事研究。
马里千的关注点是如何让AI真正参与视频创作,而不仅仅是在聊天框里回答一个问题。
目前的视频生成模型越来越强,但创作者在实际工作中仍然需要精确控制人物、场景、镜头、节奏和局部细节。简单的文本输入很难满足这种专业创作需求。
因此,Creati AI正在探索Agent-driven Video Canvas的工作方式,让AI从单纯的聊天助手变成创作工作流中的执行者。
从创意理解、脚本和分镜,到素材组织、视频生成和后期编辑,AI可以参与完整流程。同时,系统也强调内容一致性和局部编辑能力,避免每次修改都需要重新生成整个画面。
在电商UGC、短视频、品牌内容以及2到5分钟的创意短片等场景中,这种工作方式正在逐渐形成新的生产模式。
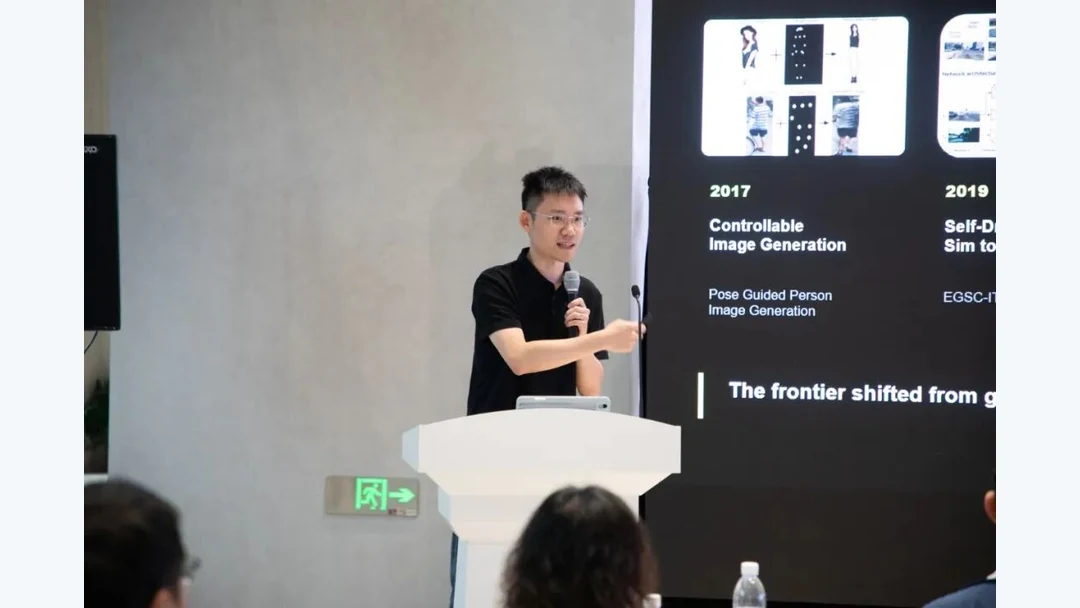
张润|让AI生成的3D真正进入生产
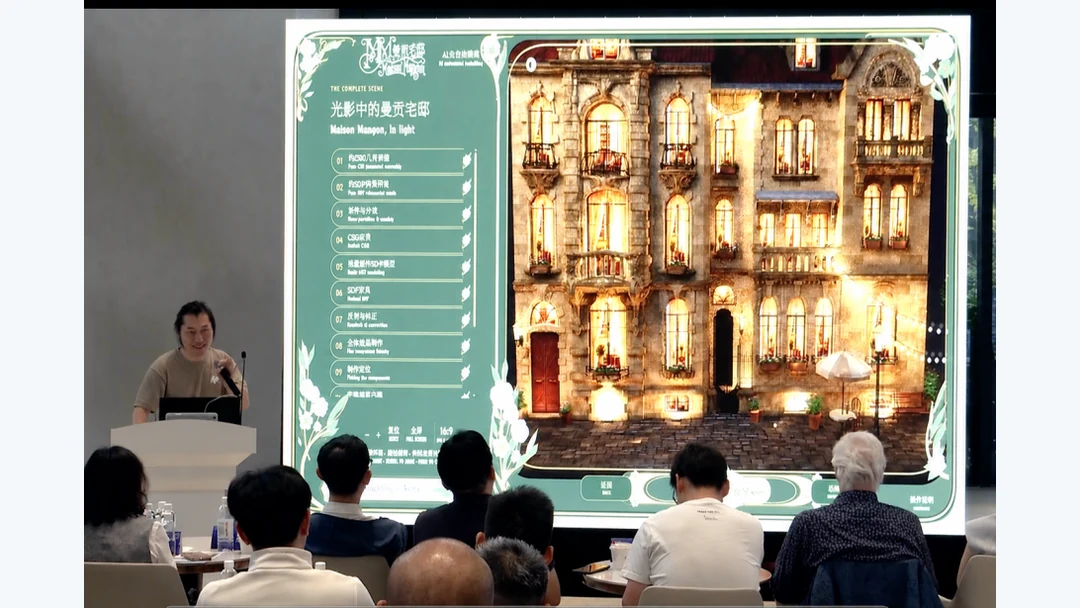
来自喵不灵文化的张润,把视角进一步拉到了AI生成3D空间。
张润拥有建筑与游戏美术背景,曾参与《无限暖暖》等游戏项目,目前正在探索AI与3D空间、建筑历史和生成式设计之间的结合,并尝试打造“AI横店”这样的空间生成工作流。
目前AI生成3D主要存在两种路线。一种是通过GPT等模型进行几何组件组合,结构相对简单;另一种是通过Tripo3D、Neural4D等体积模型生成复杂网格,但往往会产生非常密集的拓扑结构,模型面数可能达到百万级,难以直接用于生产。
因此,真正能够进入专业工作流程的方案,需要把两种方式结合起来。
张润的团队会先对建筑进行人工结构标注,再让GPT协助拆分建筑组件。简单组件采用几何生成,复杂结构则使用体积模型,再通过重新拓扑、结构优化等方式让模型重新进入可编辑的生产流程。
他现场展示了一个非常直观的效率差异:一个建筑构件用 GPT通用能力制作要花掉 10%额度,加入人的行业经验封装成skill 跑工作流,再制作同类的构件只要花费 0.067%额度。
当AI开始进入专业3D生产,真正重要的已经不是“能不能生成”,而是能否形成稳定、可复用、能够进入生产环节的工作流。
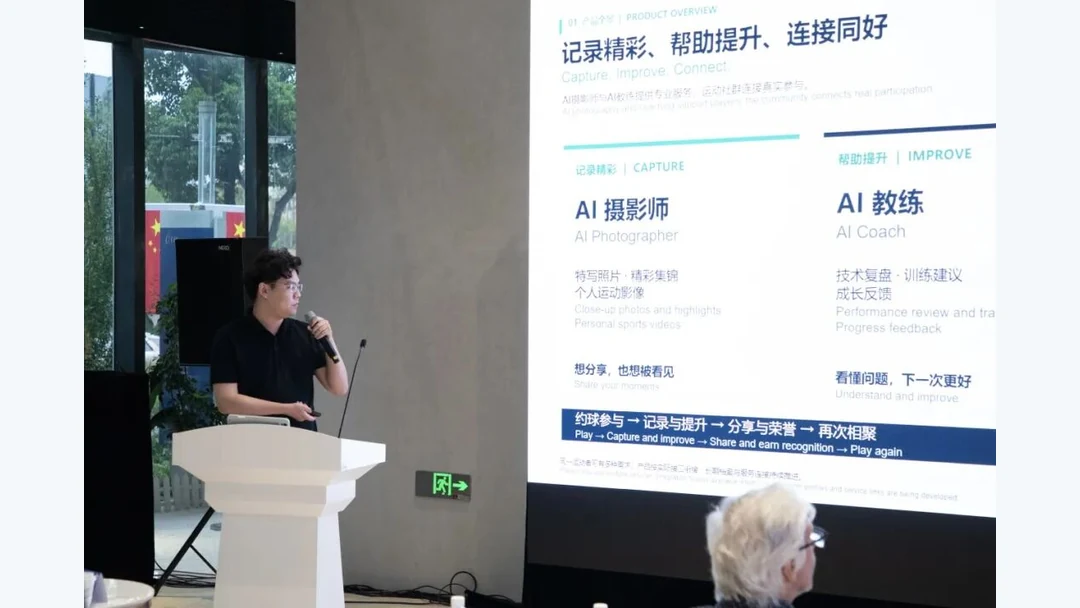
高昊|用视觉AI理解运动的时空
曦跃智能科技创始人高昊则把计算机视觉带进了体育运动。
他的团队长期研究羽毛球、网球、匹克球、滑雪、足球等运动,通过AI摄影、AI教练和运动社区产品,将传统体育训练中的大量数据转化为可以被理解和使用的信息。
团队以运动时空认知为核心,自研BAMDAS体育垂类大模型,融合高速目标追踪、人体姿态解析与三维轨迹重建,打造软硬件协同的体育Copilot,连接运动感知、技战术分析、AI指导与智能剪辑,让专业级运动智能从国家队训练场走向大众球馆,融入训练、比赛与分享的日常场景。半年覆盖十余万业余用户,服务国家队、省队等二十余家专业队伍,并为丹麦国家队队员等海外用户提供服务。以羽毛球为起点,向更多运动项目与消费场景延伸,致力成为每位运动者的专属Copilot,构建连接运动者、智能装备与体育服务的AI生态,释放全民健身与体育消费的增长潜力。
在羽毛球场景中,系统可以通过2D到3D重建理解整个场地状态,并追踪球的运动轨迹,形成80多项专业运动指标。
团队已经积累了近十年的体育数据,覆盖职业运动员和大众用户,并与国家队、省队以及国际赛事建立合作。相关技术也已经从羽毛球延伸到足球、滑雪等更多运动场景。
体育视觉AI的意义在于,它让过去依赖教练经验和人工观察的动作分析,逐渐转化为可以量化、记录和持续分析的数据。
孙振|企业AI要深入业务、解决难题
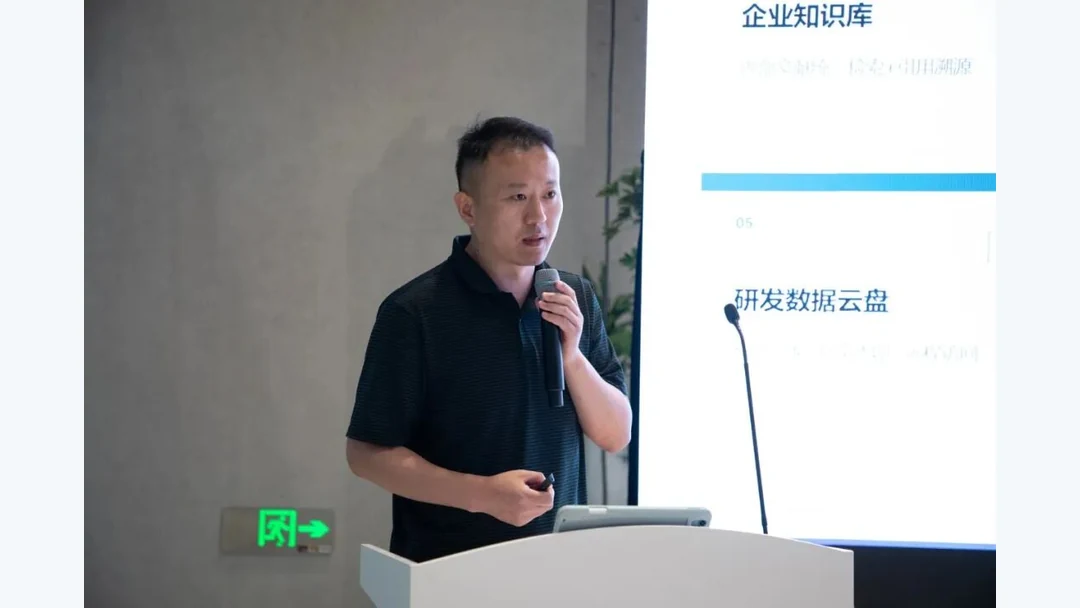
浩智辰软件创始人孙振从企业服务角度分享了AI落地过程中非常现实的一面。
孙振的团队目前主要聚焦两个方向:AI生物医药和AI工业视觉。
在生物医药领域,团队正在建设覆盖企业知识库、智能检索、Deep Research、PDF分析、靶点追踪、报告生成和AIDD等功能的平台,并计划进一步以SaaS形式提供服务。
在工业场景中,团队与招商重工等企业合作,将企业内部大量分散的SKU、术语、历史报价和业务资料进行向量化处理,让AI能够帮助员工快速完成原本需要大量人工检索的工作。
另一个案例来自电缆检测,通过工业视觉识别电缆缺陷、完成显微测量和核心识别,并进入最终验收阶段。
孙振观察到,越来越多大型企业开始大规模部署Agent,但企业内部IT团队能够解决的问题仍然有限。
真正具有价值的企业AI,需要深入具体业务,解决企业内部难以自行解决的专业问题。
朱毅伟|从具体问题开始,让AI进入业务
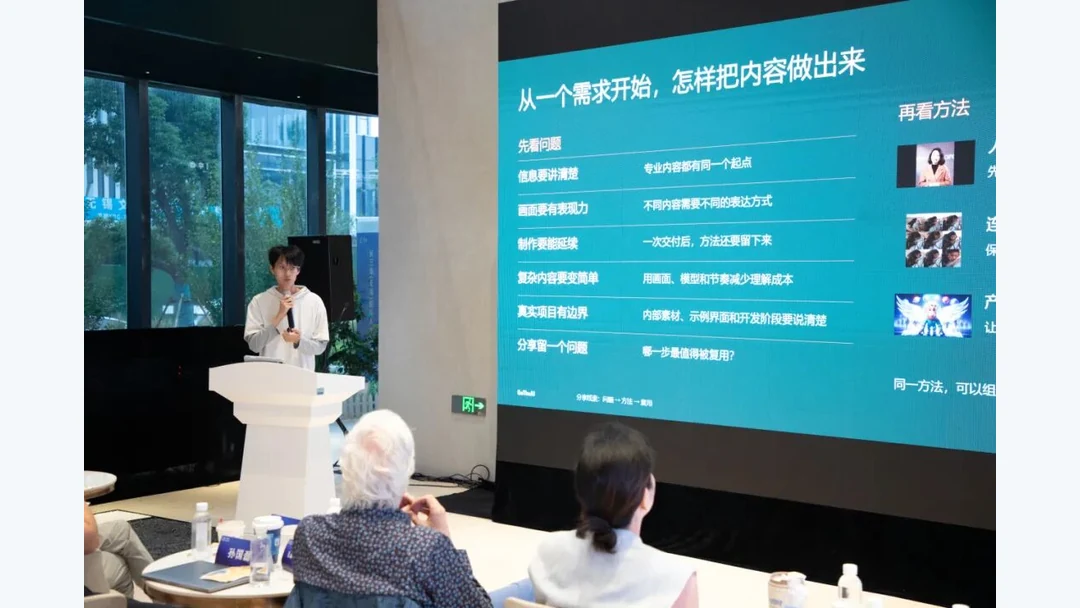
构得智能科技创始人朱毅伟则从更轻量的方向切入企业AI。
他长期关注生成式AI、AI工作流、知识库和Vibe Coding,并提出“AI as a Service”的思路,希望围绕大量垂直、具体、规模不大的需求,建立一系列轻量化AI工具。
在视频生产业务中,团队采用真实拍摄建立高质量参考素材,再通过3D和AI生成完成视觉扩展,最后使用传统后期解决AI生成过程中仍然存在的不可控细节。
在AI短剧等场景中,他们也尝试用自制生产工作台,内置影视制作智能体和组合技能,让AI生成真正进入制作流程,而不是停留在概念展示阶段。
与此同时,团队正在建设项目管理工作台和经验库,并计划持续开发一系列针对具体重复性工作的AI小工具。
AI真正进入企业,很多时候并不需要从一个宏大的系统开始。一个具体问题、一项重复工作、一个能够真正节省时间的小工具,都可能成为AI进入真实业务的入口。
赵志成|从使用AI到自主完成任务
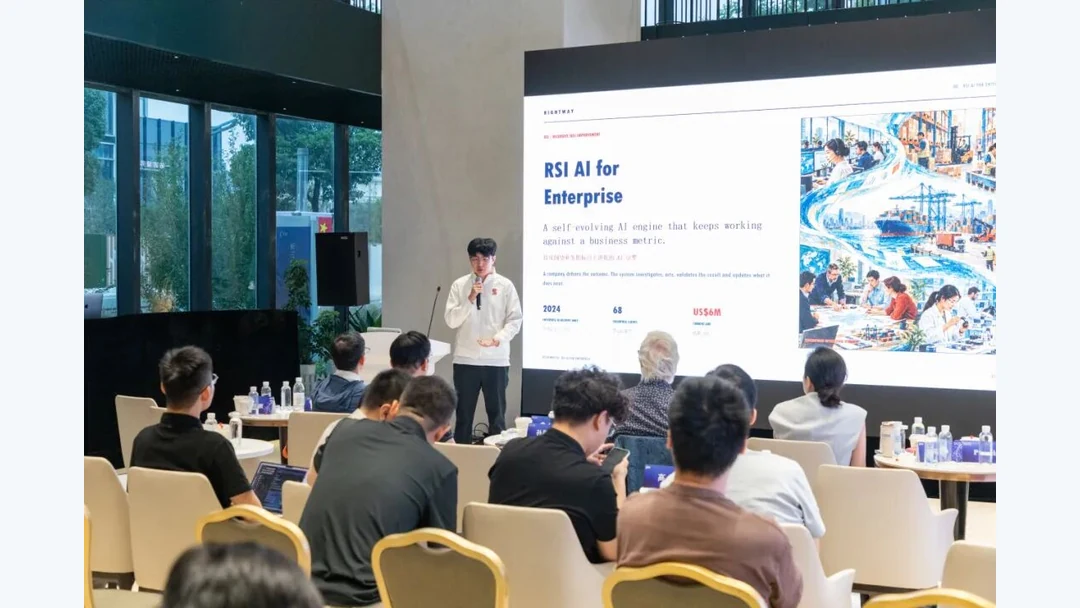
分享最后,赵志成带来的讨论进一步指向了Agent发展的下一阶段。
作为鲁汶大学校友,他后来进入NUS攻读量化分析博士,目前选择暂时离开学术路径创业,关注Agent OS和企业级智能系统。
赵志成介绍的核心思路,是让AI系统从“等待人提出问题”,转向“自己理解目标、拆解任务、执行并验证结果”。
其企业Agent OS Astra可以接受一个相对抽象的业务目标,扫描企业流程,进一步拆解任务、调度不同Agent,并通过A/B测试和持续验证完成POC,最终形成可以部署的解决方案。
在一个全球人力资源服务企业的案例中,系统让Gemini、DeepSeek等模型参与问题处理,再由Astra持续运行数天,对过程中出现的问题进行分析和迭代,最终形成可以进入生产环境的版本。
在市场拓展场景中,系统也可以针对目标市场扫描供应链、渠道以及竞争环境,并生成可以进一步验证的市场进入方案。
这意味着企业AI正在出现一个新的变化:过去,人使用AI完成任务;未来的一部分企业流程,则可能由AI理解目标之后,自主组织工具和Agent来完成任务。
从视觉智能,到更多真实的连接
针对大家的分享,Luc教授继续补充自己的观点。他谈到,AI在考古重建、建筑可视化、数字孪生等方向都有很大的探索空间。比如面对已经损毁的历史建筑,AI可以快速生成多个可能的重建版本,为研究和讨论提供新的方式;在建筑可视化中,则需要进一步平衡视觉真实感与空间、结构上的可信度。他也认为,这些方向都值得继续探索,而AI视觉创新中心可以成为推动相关研究与实践的一个连接点。
从下午开始,到自由交流结束,这场活动持续了四个多小时。难得的是,正式分享结束后,现场并没有马上散去。来自不同城市、不同研究领域和产业背景的参与者,仍然围绕技术、应用和具体项目继续深入交流。对于这样一个仍在快速变化的领域而言,能够让研究者、创业者和产业实践者坐在一起,充分讨论问题、交换想法,本身就是非常珍贵的事情。
经过这一次交流,大家也从不同方向共同勾勒出了一张关于AI视觉的“图谱”:从2D视觉到3D理解,从世界模型到生成式AI,从科学研究到体育、工业和企业应用,再到Agent与真实世界的连接。不同技术路径正在逐渐汇聚,也让我们看到AI视觉更完整的未来图景。
期待下一期映月湖创新沙龙。也期待未来的AI视觉创新中心,能够持续集聚更多AI视觉领域的人才、项目与创新力量,让不同背景的人来到这里,自由交流、深入探讨,碰撞出更多真正有价值的想法与合作。
让更多人因为AI视觉相遇,也让更多想法从这里开始发生。
映月湖创新沙龙|让思想走向实践
映月湖创新沙龙是长三角(无锡)国际人才港打造的创新交流品牌,致力于搭建一个开放、多元、跨界的思想交流与资源链接平台。我们关注前沿科技的发展及其与产业、社会的深度融合,探索技术如何转化为现实生产力,如何回应真实需求、创造社会价值,推动人类社会持续进步。每期沙龙围绕一个主题,邀请来自无锡、全国乃至全球的专家学者、行业实践者、创业者、投资人及媒体人,共同分享前沿洞察、交流实践经验、碰撞创新思想。
立足无锡东大门,我们希望以开放的视野持续连接人才、技术、产业与资本,让不同领域的智慧在此交汇,让创新从思想走向实践,为无锡的创新发展注入活力,也让锡东新城成为汇聚创新人才、孕育创新思想、创造未来可能的活力之地。
长三角(无锡)国际人才港
立足长三角、聚焦粤港澳、放眼全世界。长三角(无锡)国际人才港集聚全球科技创新资源要素,着力打造成为长三角地区的“海归第一站、双创首选地”。人才港以海外人才为目标,重点聚焦人工智能、出海服务等战略性新兴产业,围绕商务、政务、生活三大服务板块,为人才提供创新创业全周期、全链条、全方位服务,致力于成为活力迸发、环境优美、人才向往的新型园区和国际人才高地,形成一个有创新创业精神和人文关怀的人才聚落。